

// Daten
Datenplattformen: Databricks, Snowflake und Pipelines, die sich prüfen lassen
Ein Bericht für die Geschäftsführung, der in Excel entsteht, eine Pipeline, die niemand mehr anfassen will, und eine Cloud-Rechnung, die sich keinem Team zuordnen lässt. Wir bauen und migrieren Plattformen so, dass Tests, Berechtigungen und Lineage vom ersten Tag an Teil der Pipeline sind.
- Databricks
- Snowflake
- dbt
- Airflow
- Prefect
- Azure
- AWS
- SQL Server
// Kurz gesagt
Eine Datenplattform, die ihre Nachweise selbst liefert
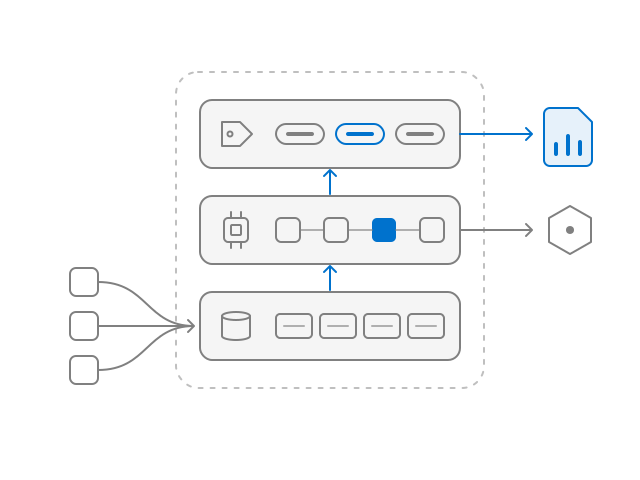
Wir entwerfen, bauen und migrieren Datenplattformen auf Databricks, Snowflake, Azure, AWS und SQL Server, mit Pipelines in dbt, Airflow oder Prefect. Jede Pipeline hat Qualitätstests, Zugriffskontrolle, Lineage und Audit-Logs. Für Daten-, IT- und Finanzteams, die Zahlen brauchen, denen Geschäftsführung, Prüfer und KI-Modelle vertrauen können.
// Was wir tun
Aufbau, Migration und Kosten im Griff
Prüfer fragen, wer wann auf welche Daten zugegriffen hat. Deshalb bauen wir Logs und Lineage gemeinsam mit der Pipeline und nicht nachträglich.
01Architektur
Entwurf und Aufbau der Plattform
Zielarchitektur auf Databricks oder Snowflake, in Azure oder AWS, mit SQL Server dort, wo er bleibt.
- Skizze der Zielarchitektur
- Datenschichten und Namenskonventionen
- Infrastruktur als Code
02Migration
Migration in Etappen
Erst ein funktionierender Ausschnitt, dann der nächste, mit Ergebnisvergleich vor jeder Umstellung.
- Migration zu Unity Catalog
- Pipelines aus SQL Server und Skripten übernehmen
- Alte und neue Pipeline laufen parallel
03Qualität und Nachweise
Pipelines, die sich prüfen lassen
Tests, Berechtigungen, Lineage und Logs gehören zur Pipeline und nicht zu einer Dokumentation, die später entsteht.
- Datenqualitätstests in dbt
- CI/CD für Daten
- Zugriffskontrolle und Audit-Logs
- Lineage von der Quelle bis zum Bericht
04Kosten
Eine Cloud-Rechnung, die sich erklären lässt
Sie sehen, welche Pipeline und welches Team Kosten verursacht und was sich abschalten lässt.
- Kosten nach Teams und Pipelines zugeordnet
- Cluster und Warehouses passend zur Last dimensioniert
- Zeitpläne statt dauerhaft laufender Ressourcen
Erster Schritt: eine Pipeline von der Quelle bis zum Bericht in 6 Wochen
Zielarchitektur und Kostenmodell
Eine Seite mit Entscheidungen: Plattform, Datenschichten, Orchestrierung und eine Schätzung der Cloud-Kosten.
Pipeline in Produktionsqualität
Eine Pipeline vom Quellsystem bis zum Bericht, mit Qualitätstests, Lineage und einem Zugriffsmodell danach, wer die Daten wirklich braucht.
Backlog der nächsten Pipelines
Priorisierte Aufgaben mit Abhängigkeiten, bereit für Ihr Team oder für uns.
Das Ergebnis: eine Pipeline in Produktion, die ihre Nachweise selbst liefert (Tests, Logs und Lineage)
Umfang und Termin stehen vor dem Start schriftlich fest. Ersten Schritt anfragen
// Umfang
Was wir tun und was nicht
Das machen wir
- Entwurf, Aufbau und Migration von Datenplattformen
- Pipelines in dbt, Airflow oder Prefect, mit Tests und CI/CD
- Migration zu Unity Catalog
- Arbeit gemeinsam mit Ihrem Team, mit Wissenstransfer
Das machen wir nicht
- Lizenzen und Werkzeuge weiterverkaufen
- Alles auf einmal migrieren, ohne einen ersten funktionierenden Ausschnitt
- Berichte auf Daten, deren Herkunft niemand zeigen kann
Die genannten Plattformen kennen wir aus Projekten. Wir beraten unabhängig von Anbietern und verdienen nicht an Lizenzen.
// Weiterlesen
Verwandte Themen und Leistungen
In unserem Blog schreiben wir über das Umfeld der Plattform:
// FAQ
Fragen zu Datenplattformen
Databricks oder Snowflake?
Das hängt von der Hauptlast ab. Databricks passt besser, wenn viel Verarbeitung in Python und Spark, maschinelles Lernen und unstrukturierte Daten anfallen. Snowflake punktet mit Einfachheit bei einem SQL-Warehouse und im Reporting. Wir vergleichen beide Optionen an Ihrer Pipeline und Ihren Kosten, bevor Sie etwas kaufen.
Wie läuft eine Migration zu Unity Catalog ab?
Zuerst eine Bestandsaufnahme: Workspaces, Tabellen im Hive Metastore, Berechtigungen und Jobs. Dann migrieren wir Bereich für Bereich und vergleichen die Ergebnisse vor der Umstellung. Dabei schalten wir Lineage und Audit-Logs ein, die Unity Catalog auf Katalogebene führt.
Arbeiten Sie mit unserem Team zusammen?
Ja, und das ist uns lieber. Wir arbeiten in Ihrem Repository und nach Ihren Standards, machen Code-Reviews gemeinsam mit dem Team, und die Dokumentation bleibt bei Ihnen. Wenn Sie einen Data Engineer länger brauchen, sehen Sie sich unsere Spezialisten für Ihr Projekt an.
Wie kalkulieren Sie die Kosten?
Unsere Arbeit kalkulieren wir vor dem Start: Umfang und Termin des ersten Schritts stehen schriftlich fest. Die Cloud-Kosten schätzen wir in der Architekturskizze und messen sie ab der ersten Pipeline, aufgeteilt nach Teams und Pipelines.
Übernehmen Sie bestehende Pipelines?
Ja. Wir beginnen mit einer Bestandsaufnahme: Was funktioniert, was versteht niemand, wo fehlen Tests. Dann übernehmen oder verbessern wir die Pipelines einzeln, mit Tests und Ergebnisvergleich.
Fangen wir mit einer Pipeline an
Nennen Sie uns den Bericht oder die Datenversorgung, die heute die meisten Probleme macht. Wir antworten innerhalb eines Arbeitstages, mit Fragen zu Quellen und Umfang.
Ersten Schritt anfragenLieber zuerst sprechen?
30 Minuten über Ihre Plattform, mit der Person, die das Projekt leitet.
30-Minuten-Gespräch vereinbaren (öffnet in einem neuen Tab)