

// Dane
Platformy danych: Databricks, Snowflake i potoki, które da się audytować
Raport zarządu liczony w arkuszu, potok, którego nikt nie odważy się zmienić, i rachunek za chmurę, którego nikt nie umie rozpisać na zespoły. Budujemy i migrujemy platformy tak, żeby testy, uprawnienia i lineage były częścią potoku od pierwszego dnia.
- Databricks
- Snowflake
- dbt
- Airflow
- Prefect
- Azure
- AWS
- SQL Server
// W skrócie
Platforma danych, która sama zostawia dowody
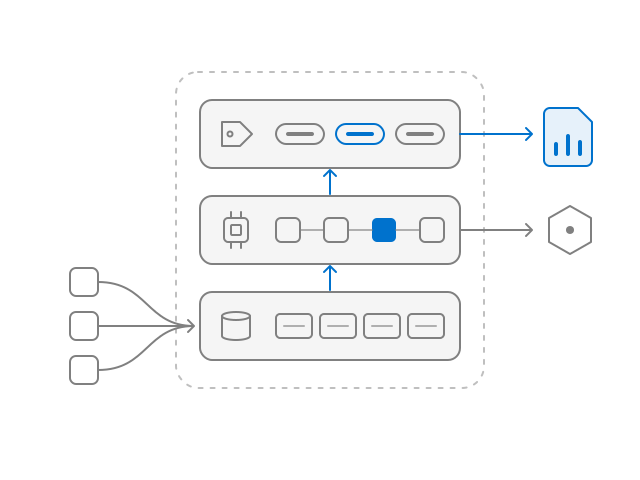
Projektujemy, budujemy i migrujemy platformy danych na Databricks, Snowflake, Azure, AWS i SQL Server, z potokami w dbt, Airflow albo Prefect. Każdy potok ma testy jakości, kontrolę dostępu, lineage i logi audytowe. Dla zespołów danych, IT i finansów, które potrzebują liczb, którym zaufają zarząd, audytor i model AI.
// Co robimy
Budowa, migracja i koszty pod kontrolą
Ustawa o KSC zalicza automatycznie generowane logi systemów do dokumentacji operacyjnej (art. 10 ust. 4, Dz.U. 2026 poz. 252, stan na 24 września 2026). Dlatego logi i lineage budujemy razem z potokiem.
01Architektura
Projekt i budowa platformy
Architektura docelowa na Databricks albo Snowflake, w Azure lub AWS, z SQL Server tam, gdzie zostaje.
- Szkic architektury docelowej
- Warstwy danych i konwencje nazw
- Infrastruktura opisana jako kod
02Migracja
Migracja etapami, nie naraz
Najpierw jeden działający przekrój, potem kolejne, z porównaniem wyników przed przełączeniem.
- Migracja do Unity Catalog
- Przeniesienie potoków z SQL Server i skryptów
- Równoległe uruchomienie starego i nowego potoku
03Jakość i dowody
Potoki, które da się audytować
Testy, uprawnienia, lineage i logi są częścią potoku, a nie dokumentacją dopisaną po fakcie.
- Testy jakości danych w dbt
- CI/CD dla danych
- Kontrola dostępu i logi audytowe
- Lineage od źródła do raportu
04Koszty
Rachunek za chmurę, który da się wyjaśnić
Wiadomo, który potok i który zespół generuje koszt, i co można wyłączyć.
- Koszty przypisane do zespołów i potoków
- Rozmiar klastrów i magazynów dobrany do obciążenia
- Harmonogramy zamiast stale działających zasobów
Pierwszy krok: jeden potok od źródła do raportu w 6 tygodni
Szkic architektury i model kosztów
Decyzje na jednej stronie: platforma, warstwy danych, orkiestracja i szacunek kosztu chmury.
Potok w jakości produkcyjnej
Jeden potok od systemu źródłowego do raportu, z testami jakości, lineage i modelem dostępu opartym na tym, kto naprawdę potrzebuje danych.
Backlog kolejnych potoków
Lista prac z priorytetami i zależnościami, gotowa do przejęcia przez Wasz zespół albo przez nas.
Na koniec: potok w produkcji z własnymi dowodami, czyli testami, logami i lineage
Stały zakres i termin ustalamy na piśmie przed startem. Zamów pierwszy krok
// Zakres
Co robimy, a czego nie robimy
Robimy
- Projekt, budowę i migrację platform danych
- Potoki w dbt, Airflow albo Prefect, z testami i CI/CD
- Migrację do Unity Catalog
- Pracę razem z Waszym zespołem, z przekazaniem wiedzy
Nie robimy
- Odsprzedaży licencji i narzędzi
- Migracji wszystkiego naraz bez pierwszego działającego przekroju
- Raportów na danych, których pochodzenia nie da się pokazać
Platformy wymienione wyżej znamy z projektów. Doradzamy niezależnie od dostawców i nie zarabiamy na licencjach.
// Czytajcie dalej
Powiązane tematy i usługi
Na blogu piszemy o tym, co dzieje się wokół platformy:
// FAQ
Pytania o platformy danych
Databricks czy Snowflake?
To zależy od głównego obciążenia. Databricks lepiej pasuje, gdy dużo jest przetwarzania w Pythonie i Sparku, uczenia maszynowego i danych nieustrukturyzowanych. Snowflake wygrywa prostotą przy hurtowni SQL i raportowaniu. Porównujemy obie opcje na Waszym potoku i Waszych kosztach, zanim cokolwiek kupicie.
Jak wygląda migracja do Unity Catalog?
Najpierw inwentaryzacja: obszary robocze, tabele w Hive metastore, uprawnienia i zadania. Potem migrujemy obszar po obszarze, z porównaniem wyników przed przełączeniem. Po drodze włączamy lineage i logi audytowe, które Unity Catalog prowadzi na poziomie katalogu.
Czy pracujecie z naszym zespołem?
Tak, i tak wolimy. Pracujemy w Waszym repozytorium i według Waszych standardów, przeglądy kodu robimy razem z zespołem, a dokumentacja zostaje u Was. Jeśli potrzebujecie inżyniera danych na dłużej, zobaczcie specjalistów na projekt.
Jak liczycie koszty?
Naszą pracę wyceniamy przed startem: stały zakres i termin pierwszego kroku są na piśmie. Koszt chmury szacujemy w szkicu architektury i mierzymy od pierwszego potoku, z podziałem na zespoły i potoki.
Czy przejmiecie istniejące potoki?
Tak. Zaczynamy od przeglądu: co działa, czego nikt nie rozumie i gdzie brakuje testów. Potem przenosimy albo poprawiamy potoki po jednym, z testami i porównaniem wyników.
Zacznijmy od jednego potoku
Wskażcie raport albo zasilanie, które dziś sprawia najwięcej kłopotu. Odpowiadamy w ciągu jednego dnia roboczego, z pytaniami o źródła i zakres.
Zamów pierwszy krokWolicie najpierw porozmawiać?
30 minut o Waszej platformie z osobą, która poprowadzi projekt.
Umów 30 minut rozmowy (otwiera się w nowej karcie)