

// Daten
Data Governance: Daten mit Verantwortlichen, Bedeutung und Änderungshistorie
In vielen Unternehmen kann niemand binnen einer Stunde sagen, welche Berichte ausfallen, wenn sich eine Tabelle ändert. Wir klären Verantwortung, Bedeutung und Herkunft Ihrer Daten, damit Änderungen, Audits und KI nicht auf Vermutungen beruhen.
// Kurz gesagt
Was ist Data Governance?
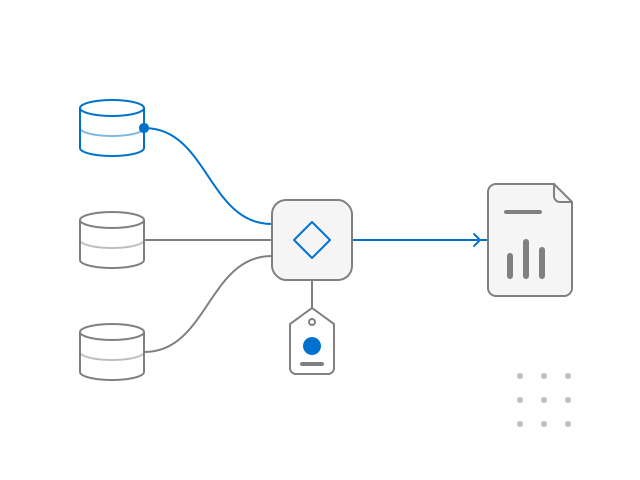
Data Governance umfasst die Regeln und Werkzeuge, mit denen jeder wichtige Datenbestand einen Verantwortlichen, eine dokumentierte Bedeutung und eine bekannte Herkunft hat. Wir setzen das für Unternehmen um, deren Berichte neben den Systemen entstehen, deren Prüfer ein Asset-Inventar sehen wollen und deren Teams Daten für KI nutzen möchten. Wir beginnen mit einem Datenfluss, nicht mit einem Jahresprogramm.
Fehlt das, ändert das Datenteam lieber nichts mehr, und die Fachbereiche bauen ihre Berichte daneben, in Excel-Dateien und privaten Datenbanken.
// Was wir tun
Vom Katalog zu KI-fähigen Daten
Das Werkzeug wählen wir zuletzt. Zuerst klären wir, wer für die Daten verantwortlich ist und was sie bedeuten.
01Katalog
Datenkatalog mit Verantwortlichen
Jeder wichtige Datenbestand hat einen fachlichen Verantwortlichen und einen technischen Betreuer, nicht nur einen Tabellennamen.
- Inventar der Datenbestände und Quellsysteme
- Verantwortliche und Betreuer je Domäne
- Zuständigkeiten im Katalog dokumentiert
02Bedeutung und Lineage
Bedeutung und Herkunft der Daten
Sie wissen, woher eine Zahl im Bericht kommt und welche Transformationen sie durchlaufen hat.
- Glossar der Fachbegriffe
- Lineage von der Quelle bis zum Bericht
- Eine abgestimmte Definition je KPI
03Änderungen
Folgenanalyse im Change-Prozess
Vor der Änderung einer Tabelle sehen Sie, welche Berichte, Modelle und externen Empfänger betroffen sind.
- Folgenanalyse im Change-Prozess verankert
- Register der Datenflüsse an Dritte
- Daten für das Asset-Inventar und das DORA-Informationsregister
04KI
Zugriff und Klassifizierung für KI
Das Modell und die RAG-Suche sehen nur, was die jeweilige Person sehen darf.
- Daten nach Schutzbedarf klassifiziert
- Berechtigungen im Katalog dokumentiert
- Für KI freigegebene Datenbestände
Erster Schritt: ein Datenfluss von Anfang bis Ende in 5 Wochen
Flusskarte mit Verantwortlichen
Wir nehmen einen Datenfluss: von der Quelle über die Pipeline bis zum Bericht und zu externen Empfängern. Jede Stufe bekommt einen Verantwortlichen.
Bedeutung und Herkunft
Begriffe und Lineage dieses Flusses dokumentieren wir im Katalog, mit einem Werkzeug, das Sie schon haben, oder einem, das wir gemeinsam auswählen.
Lücken und 90-Tage-Plan
Eine priorisierte Liste der Kontrolllücken und ein Plan für die nächsten Domänen.
Das Ergebnis: ein funktionierender Datenkatalog für eine Domäne
Umfang und Termin stehen vor dem Start schriftlich fest. Ersten Schritt anfragen
// Umfang
Was wir tun und was nicht
Wir arbeiten mit dem Werkzeug, das zu Ihrer Plattform passt: Unity Catalog, Microsoft Purview, DataHub, OpenMetadata oder dbt docs.
Das machen wir
- Datenkatalog mit Verantwortlichen und dokumentierter Bedeutung
- Lineage und Folgenanalyse für die Datenflüsse, auf die es ankommt
- Klassifizierung und Zugriffsmodell für KI und RAG
- Übergabe von Prozess und Dokumentation an Ihre Data Stewards
Das machen wir nicht
- Governance-Programme über ein Jahr, die nur auf Folien existieren
- Werkzeugkauf, bevor klar ist, wem die Daten gehören
- Alle Tabellen auf einmal beschreiben
- Lizenzen weiterverkaufen
Wenn Sie nur ein Dokument für die Akte suchen, sagen wir Ihnen im ersten Gespräch offen, ob wir dafür die Richtigen sind.
// Weiterlesen
Verwandte Themen und Leistungen
// FAQ
Fragen zu Data Governance
Brauchen wir ein neues Werkzeug?
Für den Start meist nicht. Ein Katalog lässt sich in Unity Catalog, Microsoft Purview, DataHub, OpenMetadata oder dbt docs beginnen, wenn Sie eines davon schon nutzen. Das Werkzeug wählen wir, sobald klar ist, wem die Daten gehören und was dokumentiert werden muss. Lizenzen verkaufen wir nicht.
Wer verantwortet die Daten nach dem Projekt?
Ihr Unternehmen. Die Domänenverantwortlichen sind Personen aus Ihrem Haus, im Katalog mit Name und Rolle eingetragen. Wir richten Prozess und Werkzeug ein, zeigen Ihren Data Stewards die Arbeit mit dem Katalog und übergeben die Dokumentation.
Wie hilft das bei NIS2 und DORA?
Seit dem 6. Dezember 2025 gilt in Deutschland das neue BSIG. Zu den Maßnahmen nach § 30 Abs. 2 BSIG gehören Konzepte für die Verwaltung von IKT-Systemen, und Betreiber kritischer Anlagen müssen die Umsetzung nach § 39 BSIG nachweisen (Stand: 24. September 2026). Ein Katalog mit Verantwortlichen liefert dafür einen großen Teil des Inventars der Informationswerte. Bei DORA speisen dieselben Daten das Informationsregister zu Verträgen mit IKT-Drittdienstleistern, das Finanzunternehmen bei der Aufsicht einreichen, in Deutschland bei der BaFin.
Wie bereitet das Daten für KI vor?
Ein Modell errät nicht, welche von drei gleichnamigen Tabellen aktuell ist, wer die Definition der Marge verantwortet und welche Daten das Unternehmen nie verlassen dürfen. Der Katalog hält das fest, und Klassifizierung und Berechtigungen entscheiden, was die RAG-Suche einer Person nicht zeigt. Ohne das arbeitet KI mit Vermutungen.
Wie lange dauert das?
Der erste Schritt dauert 5 Wochen und umfasst einen Datenfluss. Die nächsten Domänen planen wir in einem 90-Tage-Plan, in der Reihenfolge, die Ihre Berichte, Audits und KI-Projekte vorgeben.
Fangen wir mit einem Datenfluss an
Beschreiben Sie den Datenfluss, der heute die meisten Probleme macht: den Bericht für die Geschäftsführung, Daten für einen Kunden oder die Versorgung eines KI-Modells. Wir antworten innerhalb eines Arbeitstages, mit Fragen zum Umfang.
Ersten Schritt anfragenLieber zuerst sprechen?
30 Minuten über Ihre Daten, ohne Verkaufspräsentation.
30-Minuten-Gespräch vereinbaren (öffnet in einem neuen Tab)